

Mit der richtigen Wahl kann jedes KMU einen eigenen professionellen KI-Server vor Ort führen. Wir sagen worauf es ankommt und geben konkrete Empfehlungen basierend auf unserer praktischer Erfahrung.
Einleitung
Viele Kunden fragen uns: Gibt ob es top-moderne KIs nur in der Cloud? Existieren keine zahlbare on premise Lösungen? Während Cloud-Konzerne uns täglich mit verlockenden KI-Angeboten aus der Cloud benebeln, lassen On-Prem Lösungen für KMUs noch auf sich warten.
Für Schweizer Unternehmen in Bereichen wie Private Banking, Treuhand, Rechtswesen oder Medizinaltechnik, führt aber oft kein Weg an einer professionellen On-Premise-Infrastruktur vorbei: Die Risiken der Cloud können bei Schadensfällen wie Data Leaks oder Betriebsspionage eine zerstörende Wirkung auf die hart erarbeitete Reputation haben. Verständlicherweise wollen viele KMUs dieses Risiko nicht eingehen.
Die Unsicherheit ist gross: Welche konkreten On-Prem Lösungen für KMUs sind aktuell erfolgreich? Wie schneiden diese in der Leistung im Vergleich zur Cloud ab und was kosten sie? Auf dem Markt sehen wir leider zu viele Angebote welche auf unpassender Hardware laufen. Diese führen zu Enttäuschen und befeuern den Trugschluss, dass professionelle KIs nicht vor Ort betrieben werden können.
Wir möchten darum in diesem Artikel Klarheit schaffen und basierend auf unserer langjähriger praktischer Erfahrung konret benennen, worauf es bei einer erfolgreichen On-Prem-KI-Lösung ankommt.
Inhalt
- Die richtige KI für professionelle on premises Anwendungen auswählen
- KI-Server vs. KI direkt auf dem eigenen Rechner?
- Passende Hardware mit idealem Preis-Leistungs-Verhätnis
- Modulare Server-Software für einen reibungslosen Betrieb
Die Richtige KI für Professionelle On Premises Anwendungen Auswählen
Gibt es die besten KIs nur in der Cloud? Zumindest scheint es oft so, wenn man den Cloud-Anbietern zuhört. Tatsache ist aber: Viele der aktuell weltbesten KIs aus der Cloud sind Open Source, mit Lizenzen welche gar eine kommerzielle Nutzung kostenlos zulassen. Die Auswahl ist fast zu gross und es werden fortlaufend neue open source KIs veröffentlicht. Welche KI ist nun aber die richtige für mich? Wonach wählt man aus?
Ein einziger Faktor hat sich in der Praxis als geeigneter Startpunkt bewahrheitet: Die Modellgrösse in GB (checkpoint). Wichtig: Modellgrösse in GB ist nicht das gleiche wie die Anzahl parameter! Die Anzahl Parameter kann irreführend sein, wenn Modelle zum Beispiel stark quantifiziert sind. Die Modellgrösse in GB spielt eine entscheidende Rolle für die Intelligenz einer KI und für die Auswahl der Hardware.
Die KI-Modellgrössen im Vergleich
Die folgenden vier Modelle sind keine ewige Bestenliste, sondern eine praxistaugliche Momentaufnahme. Entscheidend ist nicht nur die Zahl der aktiven Parameter. Bei Mixture-of-Experts-Modellen müssen auch die nicht aktiven Experten im Speicher liegen. Für die Hardwareplanung zählen deshalb das konkrete Checkpoint-Format, der Kontextspeicher und die Reserven des Inferenzservers.
| Kategorie | Kompakt | Klein | Mittel | Gross |
|---|---|---|---|---|
| Beispielmodell | Granite 4.1 8B | Gemma 4 31B | DeepSeek V4 Flash | GLM 5.2 |
| Architektur | 8B Dense | 31B Dense | 284B MoE, 13B aktiv | ca. 743B MoE, 39B aktiv |
| Typischer Einsatz | Tests und technische Experimente | Allgemeine Assistenz, RAG, multimodale Aufgaben | Anspruchsvolle Agenten, Coding, langer Kontext | Komplexe Langzeitaufgaben und paralleler Enterprise-Betrieb |
| Typische Serverklasse | Kompaktsystem oder UMA | 1 × RTX PRO 6000 Blackwell | 2 × RTX PRO 6000 Blackwell | 8 × RTX PRO 6000 Blackwell |
| Praxiseinschätzung | für Geschäftsanwendungen ungeeignet | starker KMU-Allrounder | sehr hohe Qualität bei guter Effizienz | Spitzenklasse mit hohem Infrastrukturbedarf |
Granite 4.1 8B von IBM ist ein modernes, Apache-2.0-lizenziertes Modell mit Unterstützung für Deutsch, RAG, Extraktion und Function Calling. Die geringe Modellgrösse begrenzt jedoch Aufgabenverständnis, Zuverlässigkeit und fachliche Tiefe. Wir betrachten diese Klasse deshalb nicht als arbeitstaugliche Grundlage für Geschäftsanwendungen.
Gemma 4 31B ist ein dichtes, multimodales Modell von Google DeepMind mit Unterstützung für mehr als 140 Sprachen und bis zu 256’000 Kontext-Tokens. Eine RTX PRO 6000 Blackwell mit 96 GB VRAM bietet genügend Speicher für eine produktionsnahe Bereitstellung, einschliesslich einer sinnvollen Reserve für Kontext und Laufzeit.
DeepSeek V4 Flash ist ein Mixture-of-Experts-Modell mit 284 Milliarden Gesamtparametern, von denen pro Token nur 13 Milliarden aktiv sind. Der veröffentlichte Checkpoint benötigt je nach Variante rund 160 GB Speicher. Zwei RTX PRO 6000 Blackwell mit zusammen 192 GB VRAM sind deshalb eine attraktive Serverklasse. Die mögliche Kontextlänge hängt stark von Quantisierung, KV-Cache und Parallelität ab. Die theoretisch unterstützte Million Tokens ist nicht automatisch eine sinnvolle Produktionskonfiguration.
GLM 5.2 ist für lang laufende Agenten-, Coding- und Reasoning-Aufgaben ausgelegt. Das Modell umfasst ungefähr 743 Milliarden Parameter, davon rund 39 Milliarden aktiv. Der offizielle FP8-Checkpoint ist für acht GPUs mit mehr Speicher pro GPU ausgelegt. Auf acht RTX PRO 6000 Blackwell ist daher eine geeignete NVFP4-Quantisierung erforderlich. Diese Klasse verlangt sorgfältige Tests von Inferenz-Engine, PCIe-Topologie, Kühlung und Stromversorgung.
(Zu) kleine KI
Auch moderne 8B-Modelle sind für produktive Geschäftsanwendungen zu klein. In einfachen Demonstrationen wirken ihre Antworten oft überzeugend. Im Arbeitsalltag verstehen sie Aufgaben jedoch häufiger falsch, übersehen wichtige Zusammenhänge und liefern bei anspruchsvolleren Fachfragen unzuverlässige Resultate. Der dadurch entstehende Kontroll- und Korrekturaufwand macht den vermeintlichen Kostenvorteil zunichte.
Wir raten deshalb davon ab, diese Modellklasse als geschäftlichen Assistenten oder als Grundlage für automatisierte Prozesse einzusetzen. Sie eignet sich für technische Experimente und unverbindliche Tests, nicht aber für produktive KMU-Anwendungen. Für einen professionellen Einstieg empfehlen wir mindestens die nächste Klasse um 31 Milliarden Parameter.
Kleine KI
Modelle um 31 Milliarden Parameter sind heute ein überzeugender Einstieg in professionelle On-Premise-KI. Sie bieten deutlich mehr Reserven für Argumentation, RAG, Mehrsprachigkeit und multimodale Aufgaben als die 8B-Klasse. Gemma 4 31B passt auf eine einzelne professionelle 96-GB-GPU und ist deshalb ein starker KMU-Allrounder mit überschaubarer Infrastruktur.
Mittelgrosse KI
Mixture-of-Experts-Modelle wie DeepSeek V4 Flash kombinieren einen grossen Wissensspeicher mit vergleichsweise wenigen aktiven Parametern pro Token. Das ermöglicht hohe Qualität und Geschwindigkeit, ohne dass bei jeder Ausgabe alle Parameter berechnet werden. Der vollständige Checkpoint muss trotzdem in den GPU-Speicher passen. Zwei professionelle 96-GB-GPUs bilden hier eine sinnvolle Leistungsklasse für anspruchsvolle Agenten, Softwareentwicklung und umfangreiche Dokumentkontexte.
Grosse KI
Für anspruchsvolle Einsatzgebiete wie Private Banking, Treuhand, Medizintechnik oder Verteidigung kommen grosse Modelle und leistungsfähige Mehr-GPU-Server infrage. GLM 5.2 zielt auf komplexe Langzeitaufgaben, Agenten und Coding-Workloads. Eine Konfiguration mit acht RTX PRO 6000 Blackwell stellt 768 GB VRAM bereit, erfordert für dieses Modell aber eine passende Quantisierung. In dieser Klasse sind Modelltests mit den eigenen Daten, ein abgestimmtes Sicherheitskonzept und eine professionelle Betriebsumgebung unverzichtbar.
Die Modellgrösse allein garantiert keine Faktentreue. Auch grosse Modelle können Fehler machen. Für geschäftskritische Anwendungen braucht es deshalb Quellenbelege, Berechtigungen, Qualitätskontrollen und bei folgenreichen Entscheidungen eine menschliche Freigabe.
KI-Server vs. KI direkt auf dem eigenen Rechner?
Die professionelle Nutzung von KI im Unternehmen erfordert eine stabile und leistungsstarke Infrastruktur. Wir empfehlen darum Ihre KI-Anwendungen auf einem dedizierten Server zu betreiben, der speziell für diese rechenintensiven Aufgaben konfiguriert ist und unabhängig von Ihren alltäglichen Arbeitsgeräten funktioniert.
Separation of Concerns
Stabilität spielt eine entscheidende Rolle im professionellen Umfeld: Darum raten wir unseren Kunden ihre KI auf einem eigenen Server mit passender Hardware zu betreiben. Dies reduziert potenzielle Risiken wie Systemüberlastungen und gewährleistet, dass andere geschäftskritische Anwendungen ungestört weiterlaufen können.
Büro-Rechner oder Laptops sind konzipiert für die Benutzeroberfläche und Software die wenig Rechenleistung erfordert, wie zum Beispiel Office Anwendungen. Grosse KI-Modelle hingegen stellen enorme Rechenaufgaben dar und erfordern dementsprechend eine andere Umgebung der Software und Hardware.
Eine saubere Trennung ist nicht stabiler und flexibler. Wenn die KI auf einem eigenen Server läuft, lassen sich Updates, Wartung und Datensicherungen zentral und unabhängig vom Arbeitsplatz durchführen. So behalten Sie die Kontrolle über ihre Büro-Rechner, während die künstliche Intelligenz zuverlässig weiterarbeitet.
Lautstärke und Abwärme
Rechenleistung bedeutet Wärme, bedeutet Kühlung, bedeutet meistens Lärm. Ähnlich wie bei Gaming-Computern produzieren mittlere und grosse KI-Modelle viel Abwärme und dementsprechend Lärm bei der Kühlung. Für Gamer mit Kopfhörern mag dies kein Problem darstellen, aber im Büro muss man sich konzentrieren können. Die erforderliche Kühlung eines professionellen KI-Systems mit 600W ähnelt in vielerlei einem kleinen Staubsauger und stört die Konzentration.
Idealerweise hat man einen Server-Raum oder einen abschliessbaren Raum wie z.Bsp. einen Keller oder gar eine Besenkammer, wo man den KI-Server unterbringen kann. Kleinere Server-Cluster kommen dann meist ohne Klima-Anlage für den Raum aus. Wenn diese Möglichkeit nicht besteht und man einen KI-Server im Arbeitsraum aufstellen muss, dann wäre eine Wasserkühlung ratsam. Diese brauchen zwar auch Ventilatoren und sind etwas teuerer aber auch deutlich leiser bei gleicher Leistung, weil die Abwärme auf eine grössere Fläche verteilt werden kann.
Background-Tasks
Ein dedizierter KI-Server kann im Hintergrund kontinuierlich Vorarbeit leisten. Es gibt verschiedene Arten solcher “Background Tasks”. Zum einen können Dokumente indexiert werden, was zu einer deutlich effizienteren und erfolgreichen Suche mittels KI führen kann. Dabei werden Dokumente mittels Embeddings in einen vektoriellen Raum übertragen, wodurch semantische Ähnlichkeiten erkannt und Suchanfragen präziser beantwortet werden können.
Eine andere Form der Hintergrundarbeiten, die zur Effizienzsteigerung in einem KMU beitragen, ist die automatisierte Dokumentenverarbeitung. Dabei können beispielsweise eingehende E-Mails analysiert und daraus automatisch strukturierte Reports erstellt werden. Auch fortlaufende Qualitäts- und Compliance-Kontrollen lassen sich im Hintergrund durchführen, was Ressourcen spart und die Einhaltung von Standards sicherstellt.
Passende Hardware mit idealem Preis-Leistungs-Verhältnis
Professionelle KI-Modelle benötigen vor allem genügend schnellen Speicher. Der Modell-Checkpoint, der KV-Cache für den Kontext, Laufzeitpuffer und parallele Anfragen müssen gleichzeitig Platz finden. Die Zahl der Parameter allein reicht für die Dimensionierung nicht aus.
Für On-Premise-KI stehen zwei sinnvolle Plattformklassen zur Verfügung: kompakte Systeme mit gemeinsamem Speicher und dedizierte GPU-Server. Die erste Klasse bietet viel adressierbaren Speicher bei geringer Leistungsaufnahme. Die zweite liefert deutlich mehr Rechenleistung, höhere Speicherbandbreite und den reiferen NVIDIA-Software-Stack für produktive Inferenz.
Systeme mit gemeinsamem Speicher
| NVIDIA DGX Spark | AMD Ryzen™ AI Halo | Apple Mac Studio | |
|---|---|---|---|
| Prozessorplattform | NVIDIA GB10 Grace Blackwell | Ryzen AI Max+ 395 | M4 Max oder M3 Ultra |
| Gemeinsamer Speicher | 128 GB | bis 128 GB | bis 128 GB beim M4 Max, bis 512 GB beim M3 Ultra |
| Speicherbandbreite | 273 GB/s | 256 GB/s | bis 546 GB/s beim M4 Max, 819 GB/s beim M3 Ultra |
| KI-Software | CUDA, NVIDIA AI Stack | ROCm | MLX, Metal |
| Leistungsaufnahme der Plattform | 240-W-Netzteil | bis 120 W TDP | abhängig von der Konfiguration |
| Stärke | CUDA in einem kompakten System | gutes Verhältnis aus Speicher, Preis und Effizienz | sehr grosse Speicherkapazität und leiser Desktop-Betrieb |
| Einschränkung | viel langsamerer Speicher als eine dedizierte RTX PRO GPU | Softwarekompatibilität vorab prüfen | anderer Software-Stack als übliche Linux-GPU-Server |
Diese Systeme sind besonders interessant für Entwicklung, Pilotprojekte, leise Einzelplatzlösungen und grosse quantisierte Modelle mit moderatem Durchsatz. Viel gemeinsamer Speicher bedeutet jedoch nicht automatisch hohe Geschwindigkeit.
Professionelle GPU-Server
| 1 GPU | 2 GPUs | 8 GPUs | |
|---|---|---|---|
| GPU | 1 × RTX PRO 6000 Blackwell Server Edition | 2 × RTX PRO 6000 Blackwell Server Edition | 8 × RTX PRO 6000 Blackwell Server Edition |
| Gesamter VRAM | 96 GB GDDR7 mit ECC | 192 GB GDDR7 mit ECC | 768 GB GDDR7 mit ECC |
| Speicherbandbreite, theoretisch addiert | 1,6 TB/s | 3,2 TB/s | 12,8 TB/s |
| GPU-Leistungsaufnahme maximal | 600 W | 1’200 W | 4’800 W |
| Passendes Beispielmodell | Gemma 4 31B | DeepSeek V4 Flash | GLM 5.2 in geeigneter NVFP4-Quantisierung |
| Typische Rolle | leistungsfähiger KMU-Inferenzserver | anspruchsvolle Agenten und mehr Durchsatz | zentrale KI-Plattform für komplexe Modelle und viele Nutzer |
Die RTX PRO 6000 Blackwell Server Edition ist eine professionelle Rechenzentrumskarte mit 96 GB GDDR7-ECC-Speicher und bis zu 1,6 TB/s Speicherbandbreite. Anders als Consumer-GPUs ist sie auf dichte Serverkonfigurationen, langen Betrieb und Enterprise-Workloads ausgerichtet. Ob eine konkrete Konfiguration die volle Leistung erreicht, hängt vom Servergehäuse, der Stromversorgung, Kühlung, PCIe-Topologie und Inferenzsoftware ab.
Preise und Durchsatz ändern sich schnell und hängen stark von Modellformat, Kontextlänge und Parallelität ab. Wir empfehlen deshalb keine pauschale Angabe in Wörtern pro Sekunde. Belastbare Beschaffung beginnt mit einem Benchmark des gewünschten Modells auf der vorgesehenen Serverkonfiguration.
Grafikkarten
Dedizierte GPUs sind für interaktive und parallele KI-Inferenz weiterhin die leistungsfähigste Standardlösung. Ihre Stärke liegt in der Kombination aus hoher Speicherbandbreite, spezialisierten Tensor-Recheneinheiten und ausgereiften Inferenz-Frameworks.
Für professionelle On-Premise-Systeme empfehlen wir Server-GPUs mit ECC-Speicher, dokumentierter Kühlung und einem klaren Supportpfad. Consumer-Grafikkarten können in Labors attraktiv wirken, sind wegen kleinerem Speicher, Gehäuseanforderungen und fehlender Auslegung für dichte Mehr-GPU-Server aber keine Grundlage für die hier empfohlenen KMU-Systeme.
Unified Memory Architecture (UMA)
Bei einem klassischen GPU-Server besitzt die CPU ihren Arbeitsspeicher und jede GPU ihren eigenen VRAM. Das Modell muss in den GPU-Speicher geladen und bei mehreren GPUs aufgeteilt werden. Dieser Aufbau liefert sehr hohe Bandbreite und Rechenleistung, setzt aber klare Grenzen durch den verfügbaren VRAM jeder Karte und die Verbindungen zwischen den GPUs.
Bei einer Unified Memory Architecture greifen CPU und integrierte Beschleuniger auf einen gemeinsamen Speicherpool zu. Dadurch entfällt das Kopieren grosser Datenmengen zwischen getrenntem RAM und VRAM. Vor allem aber kann ein grosser Teil des Systemspeichers für das Modell verwendet werden. Das macht kompakte Systeme mit 128 GB oder mehr gemeinsamem Speicher für grosse, quantisierte Checkpoints interessant.
Die drei Plattformen verfolgen unterschiedliche Ansätze. NVIDIA DGX Spark kombiniert 128 GB kohärenten Speicher mit CUDA und dem NVIDIA-Software-Stack. AMD Ryzen™ AI Halo bietet bis zu 128 GB gemeinsamen LPDDR5x-Speicher, ROCm sowie Linux- und Windows-Unterstützung. Apple Mac Studio erreicht mit M3 Ultra bis zu 512 GB Unified Memory und eine hohe Speicherbandbreite, verwendet für lokale KI aber primär MLX und Metal statt CUDA.
UMA ist kein pauschaler Geschwindigkeitsvorteil. DGX Spark und Ryzen AI Halo erreichen rund 273 beziehungsweise 256 GB/s. Eine einzelne RTX PRO 6000 Blackwell erreicht bis zu 1,6 TB/s. Der Mac Studio M3 Ultra liegt mit 819 GB/s dazwischen. Systeme mit gemeinsamem Speicher punkten deshalb vor allem bei Kapazität, Effizienz, Lautstärke und kompakter Bauform. Dedizierte GPU-Server punkten bei Durchsatz, Parallelität und der Breite produktiver Inferenzsoftware.
Für die Auswahl gilt: Passt ein Modell samt Kontext und Reserve auf eine professionelle GPU, ist diese meist die schnellere Serverlösung. Ist sehr viel Speicher bei moderatem Durchsatz gefragt, kann UMA wirtschaftlicher und einfacher sein.
Cluster
Bei Mehr-GPU-Systemen werden Modellgewichte und Rechenarbeit über mehrere Beschleuniger verteilt. Der verfügbare Speicher addiert sich nur dann sinnvoll, wenn die Inferenzsoftware das Modell korrekt parallelisiert. Gleichzeitig entstehen Kommunikationskosten zwischen den GPUs.
Eine RTX PRO 6000 Blackwell Server Edition ist über PCIe angebunden und besitzt kein NVLink. Bei zwei oder acht GPUs müssen deshalb Mainboard-Topologie, PCIe-Lanes, NUMA-Zuordnung und NCCL-Konfiguration sorgfältig geplant werden. Acht Karten in acht beliebigen Rechnern sind nicht automatisch mit einem abgestimmten Acht-GPU-Server vergleichbar.
Mehr GPUs können zwei unterschiedliche Ziele verfolgen: Ein grosses Modell wird per Tensor- oder Expert-Parallelismus aufgeteilt, oder mehrere Modellinstanzen erhöhen den Durchsatz für parallele Nutzer. Die zweite Variante skaliert meist einfacher. Für eine verlässliche Planung müssen Time to First Token, Ausgabe-Tokens pro Sekunde, Kontextlänge und gleichzeitige Anfragen gemeinsam getestet werden.
Modulare Server-Software für einen reibungslosen Betrieb
Jeder kennt das Problem: Windows braucht wieder mal ein Update und danach funktioniert etwas auf einmal nicht mehr. Diesem Phänomen liegt die Tatsache zugrunde, dass Programme von verschiedenen Entwicklern auf einem Rechner zusammenarbeiten müssen, ohne sich gegenseitig zu stören. Es bestehen Abhängigkeiten die bei Updates durcheinander geraten können.
Betriebssysteme wie Windows, Linux oder OSX wurden über Jahrzehnte kontinuierlich weiterentwickelt und verbessert. Im professionellen Bereich gibt es aber meistens eine Null-Toleranz für Inkompatibilitäten. Es kommen darum zusätzliche Mittel zum Einsatz um Stabilität und Prozesssicherheit zu maximieren und dementsprechend Wartungsaufwand und Ausfälle zu reduzieren.
Docker Compose
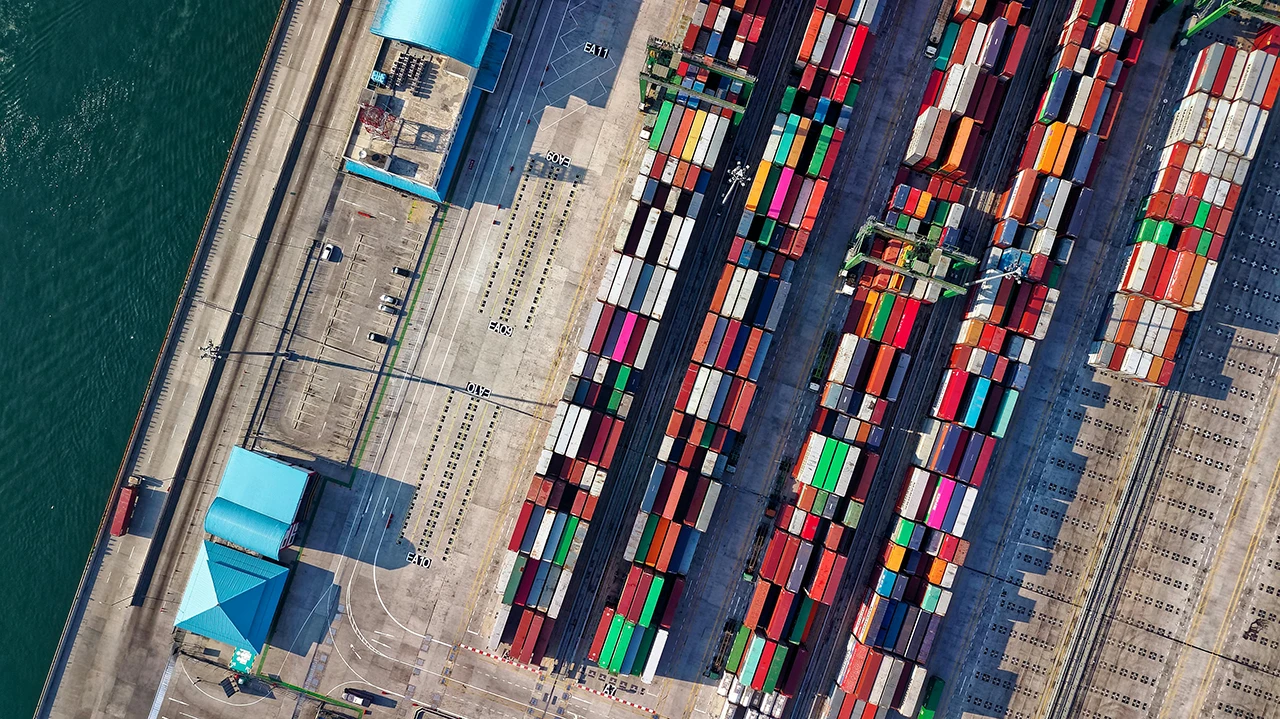 Foto von Tom Fisk
Die wohl bekannteste und am weitesten verbreitete Platform für einen modularen Betrieb komplexer Software heisst “Docker Compose”. Docker basiert auf dem Konzept von sogenanten “Containern”, ähnlich zu Schiffscontainern im globalen Handel. Durch rigorose Standards der Form-Faktoren und statischen Anforderungen passen Container weltweit auf verschiedenste Schiffe, Züge und Lastwagen und lassen sich beliebig stapeln, komplett unabhängig von ihrem Inhalt. Sie sind weltweit einsetzbar.
Software-Container sind ebenso inhaltlich unabhängig von ihrer Umgebung. Für Unternehmen bedeutet dies, dass verschiedene Anwendungen isoliert und sicher laufen können, ohne dass Konflikte entstehen. Docker Compose eignet sich besonders für kleinere KMU-Setups und den schnellen Einstieg in die professionelle KI-Welt.
Über eine kompakte docker-compose.yml-Datei lassen sich mehrere Services, etwa eine KI-API, eine Datenbank und ein Web-Frontend, mit einem einzigen Befehl starten. Dies reduziert die Komplexität erheblich und ermöglicht es auch IT-Teams ohne tiefe DevOps-Erfahrung, eine stabile On-Prem-Infrastruktur einzurichten. Besonders überzeugend: Updates und Rollbacks lassen sich mit Compose sehr einfach durchführen, was die Betriebssicherheit in KMUs deutlich steigert.
Typische Anwendungsfälle in KMUs sind:
- Bereitstellung einzelner KI-Instanzen für die interne Nutzung
- Dokumentensuche mit Elasticsearch oder MeiliSearch kombiniert mit einer KI-Schnittstelle
- Kleine Pilotprojekte, die sich später auf Kubernetes skalieren lassen
Kubernetes
Sobald dutzende Nutzer gleichzeitig auf eine KI-Infrastruktur zugreifen oder verschiedene Modelle parallel betrieben werden sollen, ist Kubernetes die professionelle Lösung. Kubernetes bietet automatisches Skalieren, Lastverteilung und Selbstheilungsmechanismen, wenn ein Service ausfällt. Dadurch lassen sich auch größere Setups mit mehreren GPU-Servers in einem Cluster stabil betreiben.
Für KMUs ist der Einstieg in Kubernetes zwar komplexer, bringt jedoch klare Vorteile:
- Zentrale Verwaltung von Clustern mit mehreren KI-Servern
- Automatisches Ausrollen von Updates ohne Ausfallzeit
- Integration von Load-Balancern, Secrets und Monitoring-Tools
- Flexible Erweiterung um weitere Services wie Vector-Datenbanken oder API-Gateways
Besonders in sensiblen Branchen wie Banking und Medizin, in denen hohe Verfügbarkeit Pflicht ist, lohnt sich Kubernetes als stabile Grundlage. In kleineren Umgebungen ist oft ein hybrider Ansatz sinnvoll: Pilotphase mit Docker Compose, Skalierung später auf Kubernetes.
Fernwartung
Bei On-Premise-Systemen ist eine professionelle Wartung sehr empfehlenswert. Ausfälle können den Geschäftsbetrieb massiv stören. Tools zur Fernwartung sorgen dafür, dass Systemadministratoren jederzeit einen Überblick über die Performance behalten und im Falle von Störungen frühzeitig eingreifen können.
Wichtige Bausteine für die Fernwartung sind:
- Prometheus + Grafana für detaillierte Metriken (GPU-Auslastung, Speicherverbrauch, Netzwerklast)
- Alertmanager mit E-Mail, SMS oder Teams/Slack-Benachrichtigungen bei kritischen Zuständen
- Remote-Logging-Lösungen wie Loki oder ELK-Stack, um Fehlerursachen im Nachhinein nachvollziehen zu können
- VPN-Tunnel für sicheren Zugriff auf Dashboards und Wartungssysteme, auch außerhalb des Büros
Ein modular aufgebautes Überwachungs-Setup sorgt nicht nur für Sicherheit, sondern auch für Transparenz: Entscheidungsträger können die Effizienz ihrer On-Premise-KI jederzeit nachvollziehen und argumentieren so besser gegenüber der Geschäftsleitung, dass sich die Investition lohnt.