

 Swiss Engineering Server S2: Enterprise-KI für Ihr ganzes Team
Unser meistgewählter Server: 2x NVIDIA RTX PRO 6000 Blackwell mit 192 GB VRAM, vorinstallierter onprem.ai Software und den neuesten LLM-Modellen. Einzeln einsetzbar, als Cluster skalierbar.
Ein Server, der ein ganzes Team versorgt
Konzipiert für Teams in regulierten Branchen wie Recht, Finanzen und Gesundheit. Alle Daten werden ausschliesslich on premises verarbeitet, auf Wunsch vollständig air-gapped. Dank OpenAI-kompatibler APIs ersetzt der S2 Cloud-KI-Dienste ohne Codeänderungen.
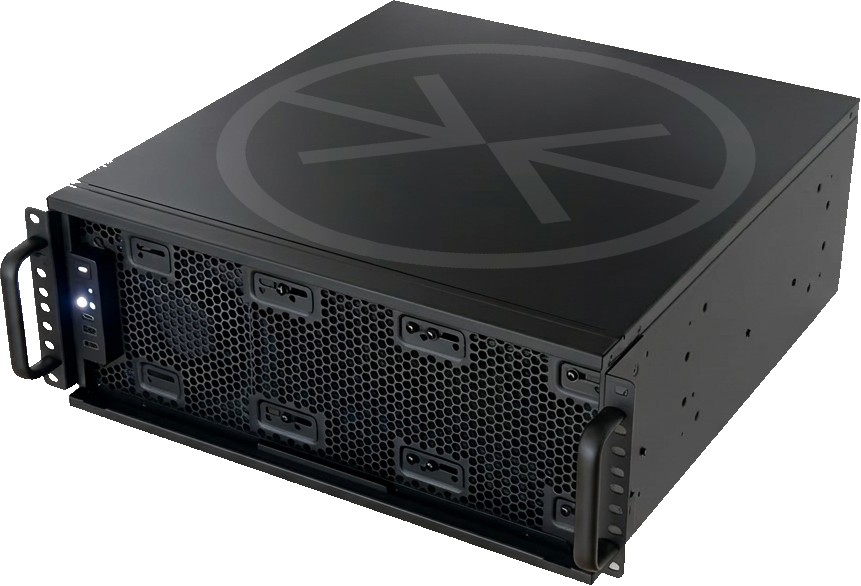
- GPUs
- 2x NVIDIA RTX PRO 6000 Blackwell
- VRAM
- 192 GB @ 1.8 TB/s
- KI-Leistung
- 8000 AI TOPS
- Leistungsaufnahme
- ~1.8 kW max
- Formfaktor
- 4U Rack
- Nutzer
- 5 - 20 gleichzeitig
Gebaut für Geschwindigkeit
Ein einzelner S2 betreibt DeepSeek v4 flash mit vollem 1M-Kontext und bedient damit ein ganzes Team gleichzeitig. Die wichtigsten Messwerte:
Textgenerierung bei parallelen Anfragen, 200 Tokens/s im Einzelbetrieb
Verarbeitung von Eingaben bei parallelen Anfragen
Kontextfenster, mit 1,4M Tokens KV-Cache
Gleichzeitig im Office-Einsatz, plus 10 parallele Coding-Agenten
Dokumentenklassifikation im Dauerbetrieb
Generierte Tokens, dazu 26 Mrd. verarbeitete Eingabe-Tokens
Vorläufige Messwerte mit DeepSeek v4 flash auf dem Server S2, Stand August 2026. Verifizierung läuft.
Weitere Konfigurationen
Alle Konfigurationen laufen mit derselben Software und lassen sich einzeln betreiben oder zu einem Cluster verbinden. Erweitern Sie die Kapazität, sobald Ihr Bedarf wächst.
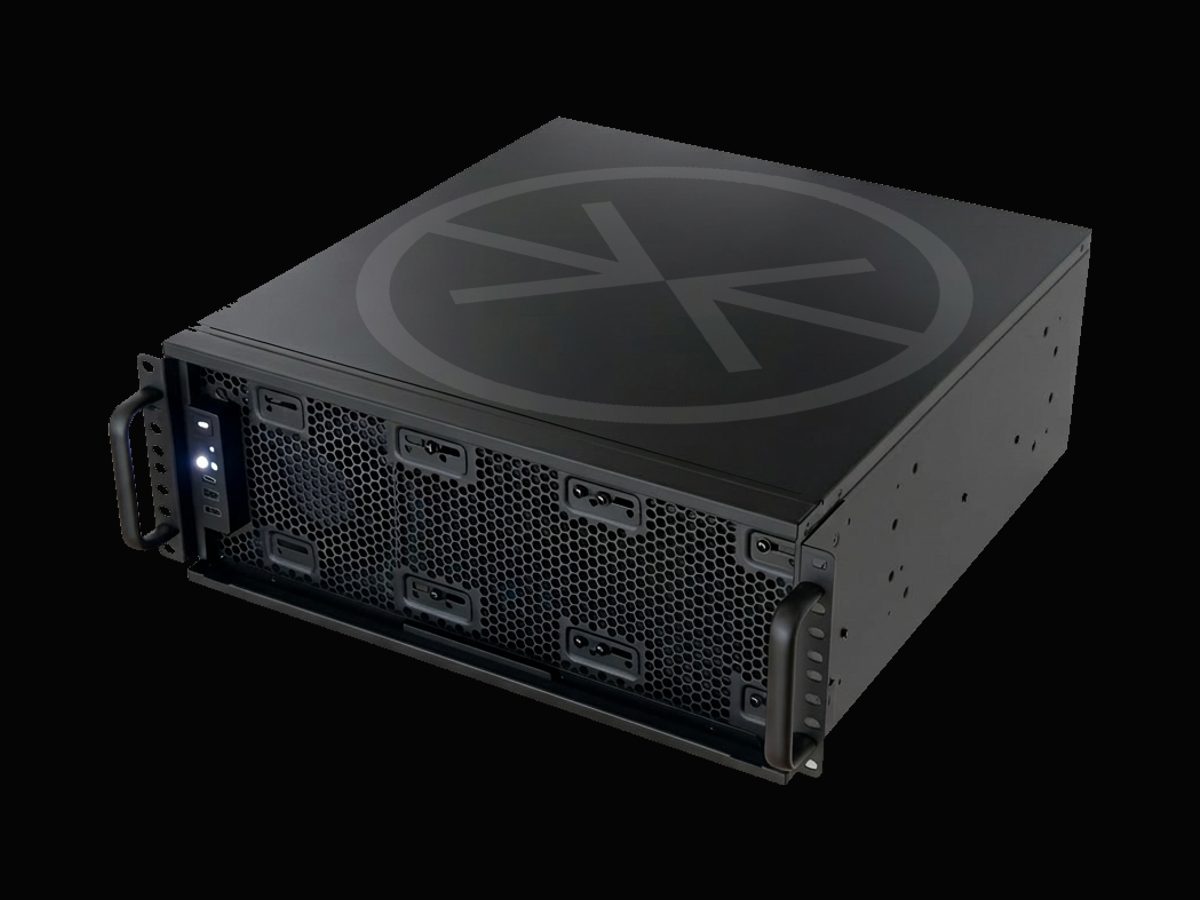
- 1x Blackwell GPU
- Nvidia RTX6000WS
- 96 GB VRAM @ 1.8 TB/s
- 4000 AI TOPS
- ~1 KW max
Der kompakte Einstieg: eine RTX PRO 6000 Blackwell im 2U-Chassis, ideal für erste produktive Anwendungen und Pilotprojekte.
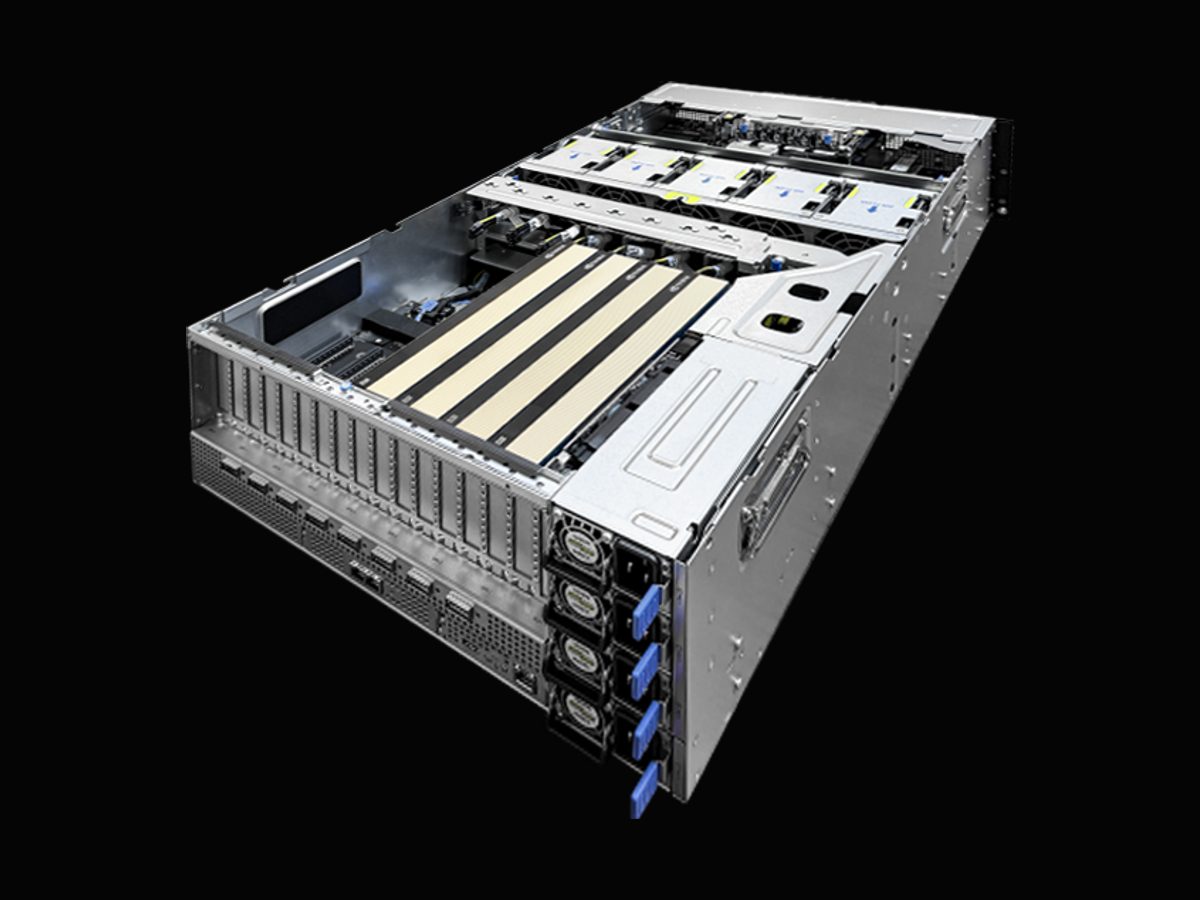
- 4x Blackwell GPU
- Nvidia RTX6000S
- 384 GB VRAM @ 1.6 TB/s
- 16000 AI TOPS
- ~3 KW max
Vier GPUs in einem System für Abteilungen mit mehreren parallelen Workloads, von RAG über OCR bis zu Coding-Agenten.
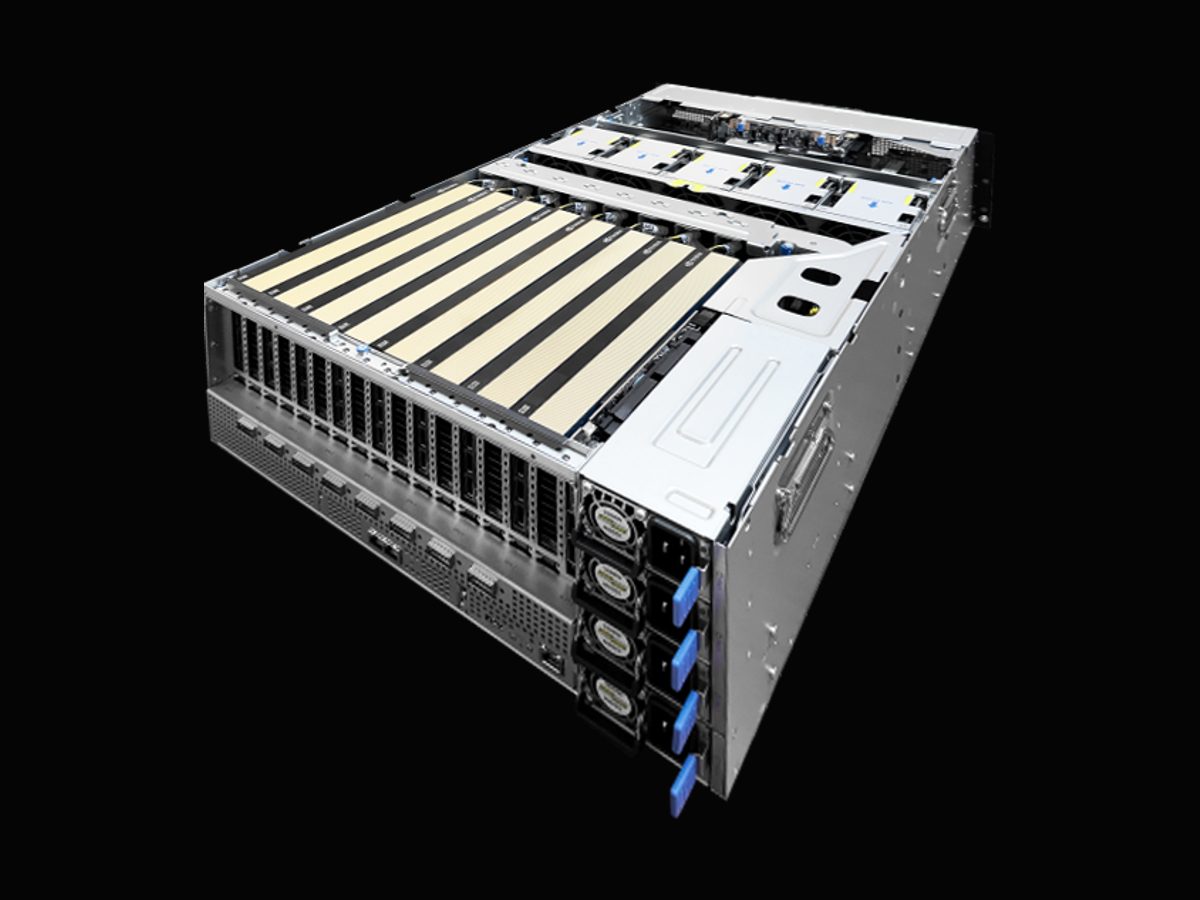
- 8x Blackwell GPU
- Nvidia MGX RTX6000S
- 768 GB VRAM @ 1.6 TB/s
- 32000 AI TOPS
- ~5.4 KW max
Acht GPUs für den unternehmensweiten Einsatz: grosse Modelle, hohe Parallelität und Reserven für neue Anwendungsfälle.
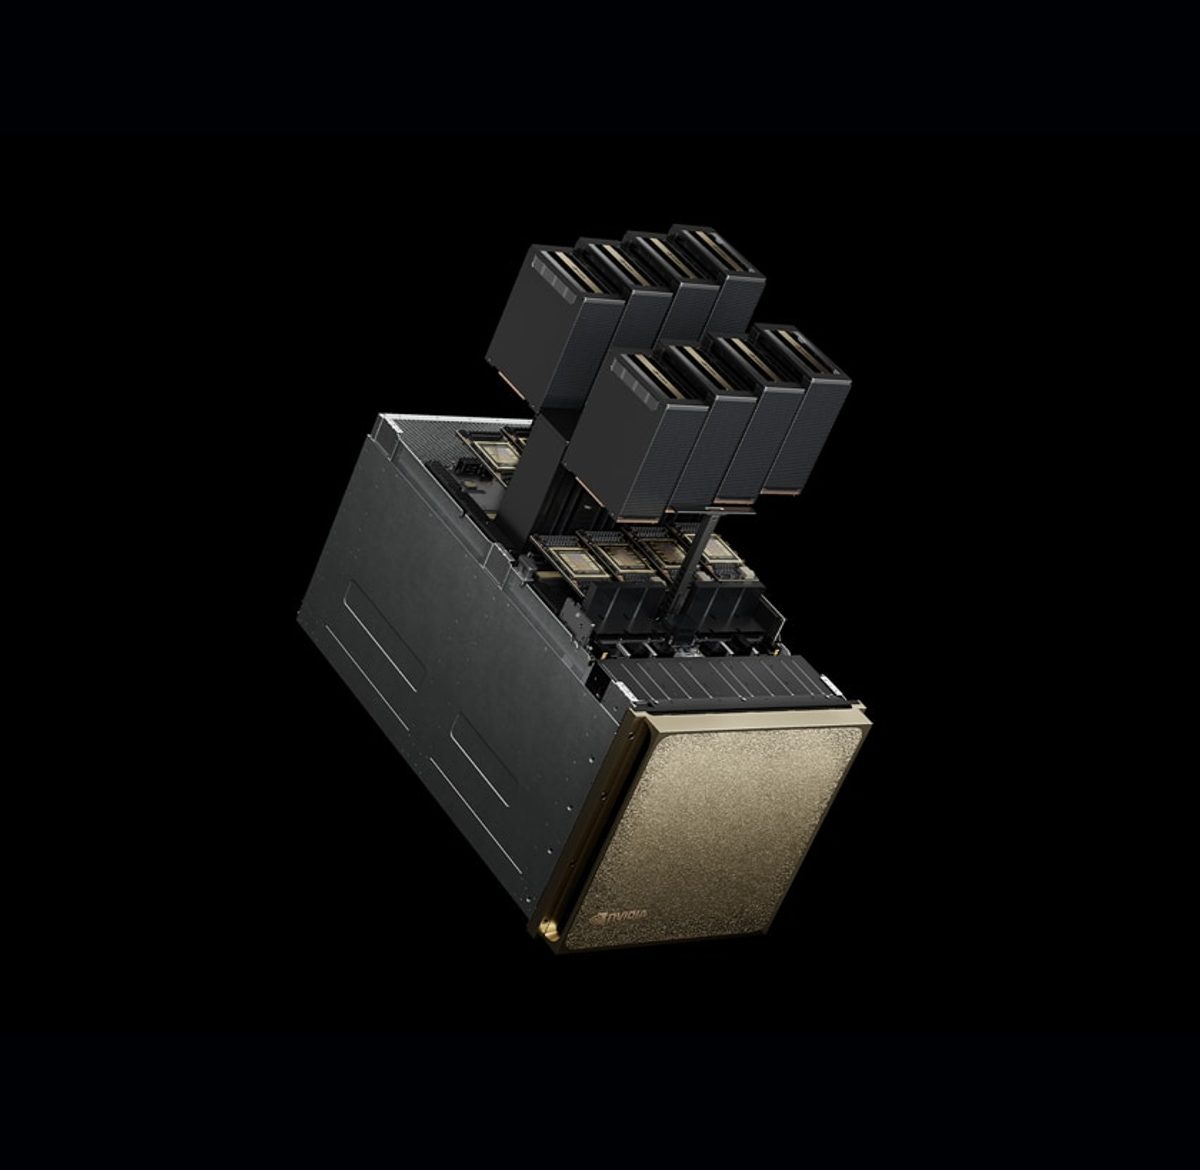
- 8x Blackwell GPU
- Nvidia DGX B200
- 1440 GB VRAM @ 8 TB/s
- 144000 AI TOPS
- ~14.3 KW max
NVIDIAs Referenzsystem für das Rechenzentrum: acht B200-GPUs mit NVLink, für Training, Fine-Tuning und die Inferenz der grössten Modelle.
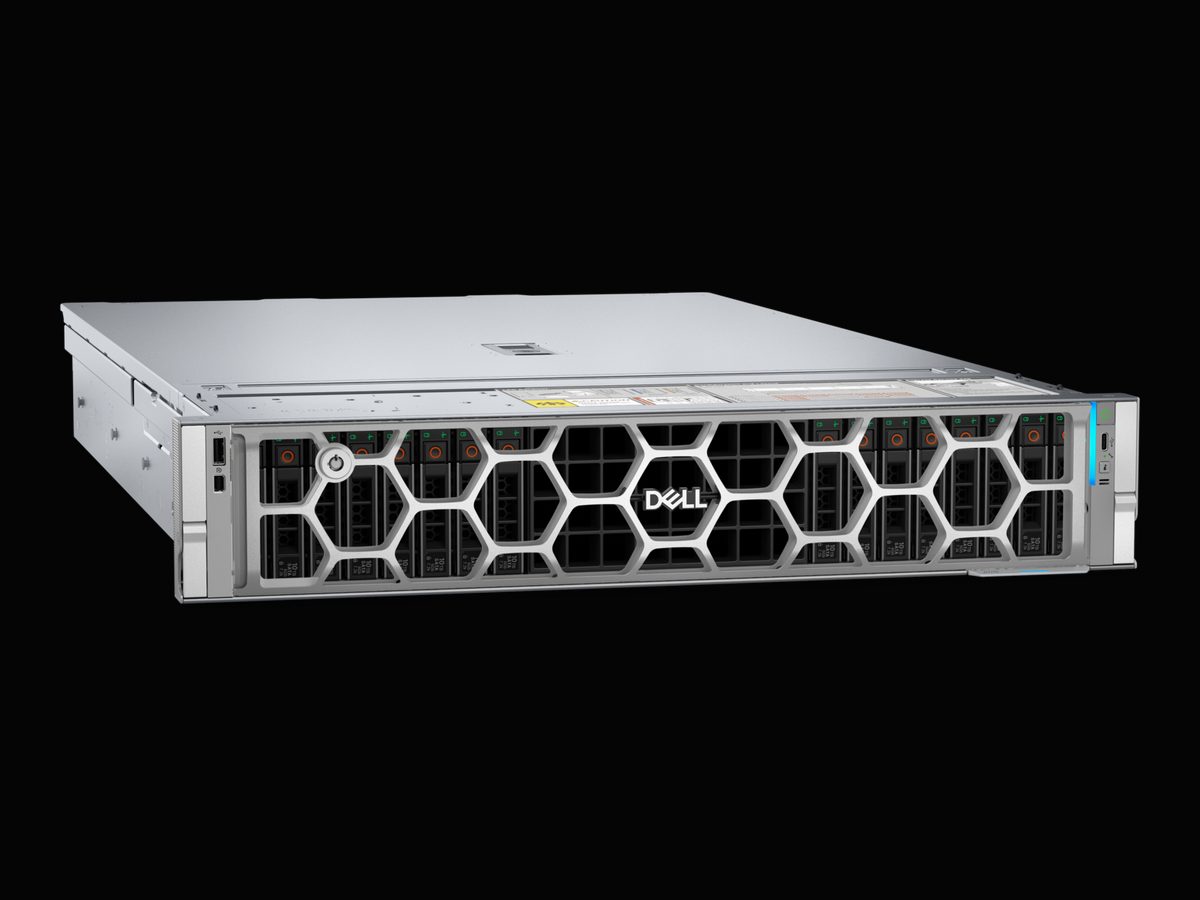
- 2U Rack
- Bis 3 GPUs
- 2-GPU-Konfiguration: Server S2
Das kompakte 2U-Chassis hinter S1 und S2: mit einer oder zwei RTX PRO 6000 Blackwell bestückt und leise genug für den Betrieb in vorhandenen Serverräumen.
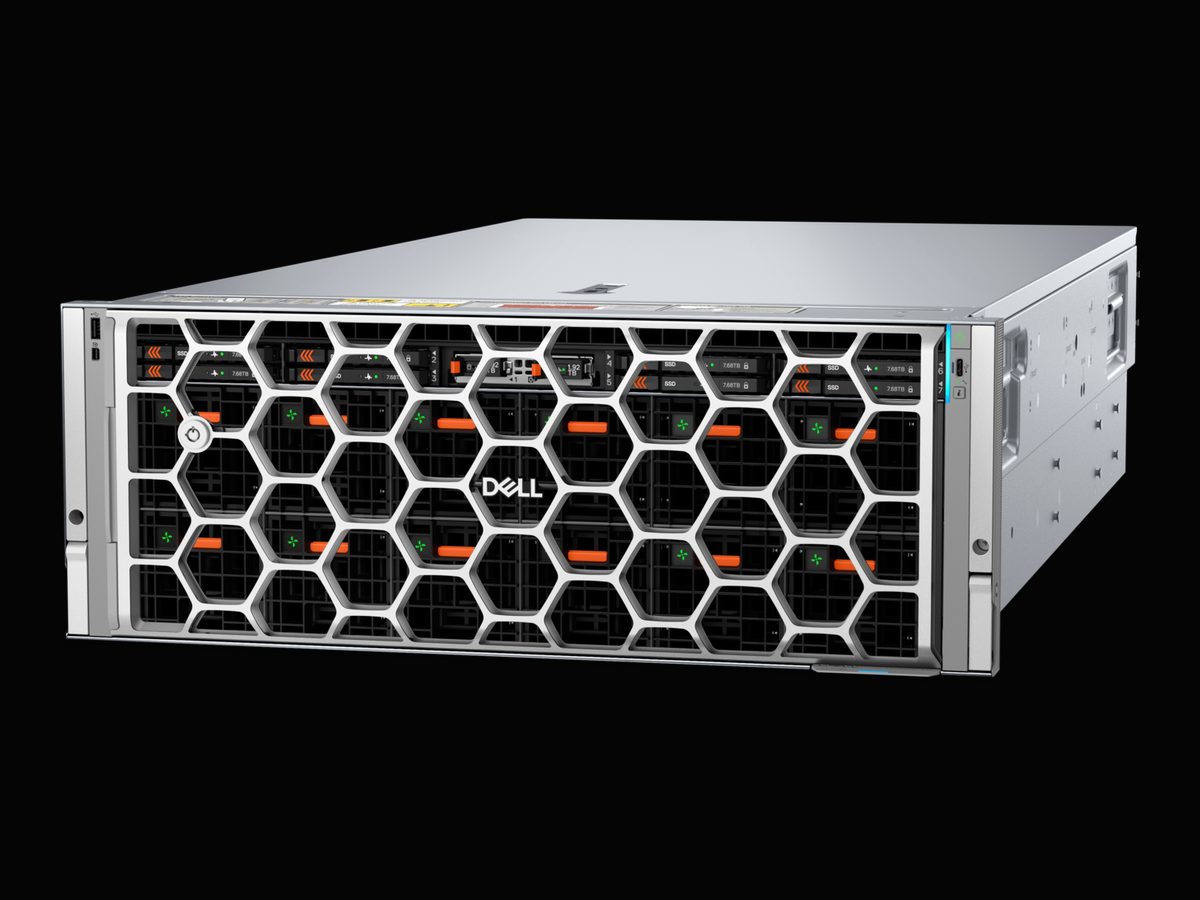
- 4U Rack
- Bis 8 GPUs
- 8-GPU-Konfiguration: DC8
Das grosse 4U-Chassis hinter DC4 und DC8: bis acht GPUs pro System, ausgelegt auf hohe Dichte im Rechenzentrum und den Ausbau zum KI-Cluster.